本地部署大模型怎么选?一篇文章看懂模型名称里的参数量、版本与量化信息!
第一次下载本地大模型,最容易卡在一长串名字上:Llama-3.1-8B-Instruct、Qwen2.5-Coder-7B-Instruct-Q4_K_M.gguf、Qwen3-30B-A3B……这些字符通常在提示模型系列、用途、规模或文件类型,但模型名称没有统一的命名标准。同一个词在不同发布者那里也可能含义不同,最后要以模型卡和实际文件为准。
如果你只想先选一个能直接聊天的模型:优先找 Instruct 或 Chat 版本;再看参数量和量化后的文件大小是否适合你的设备;最后确认文件格式能被你准备使用的本地运行工具支持。
先分清模型仓库名和权重文件名
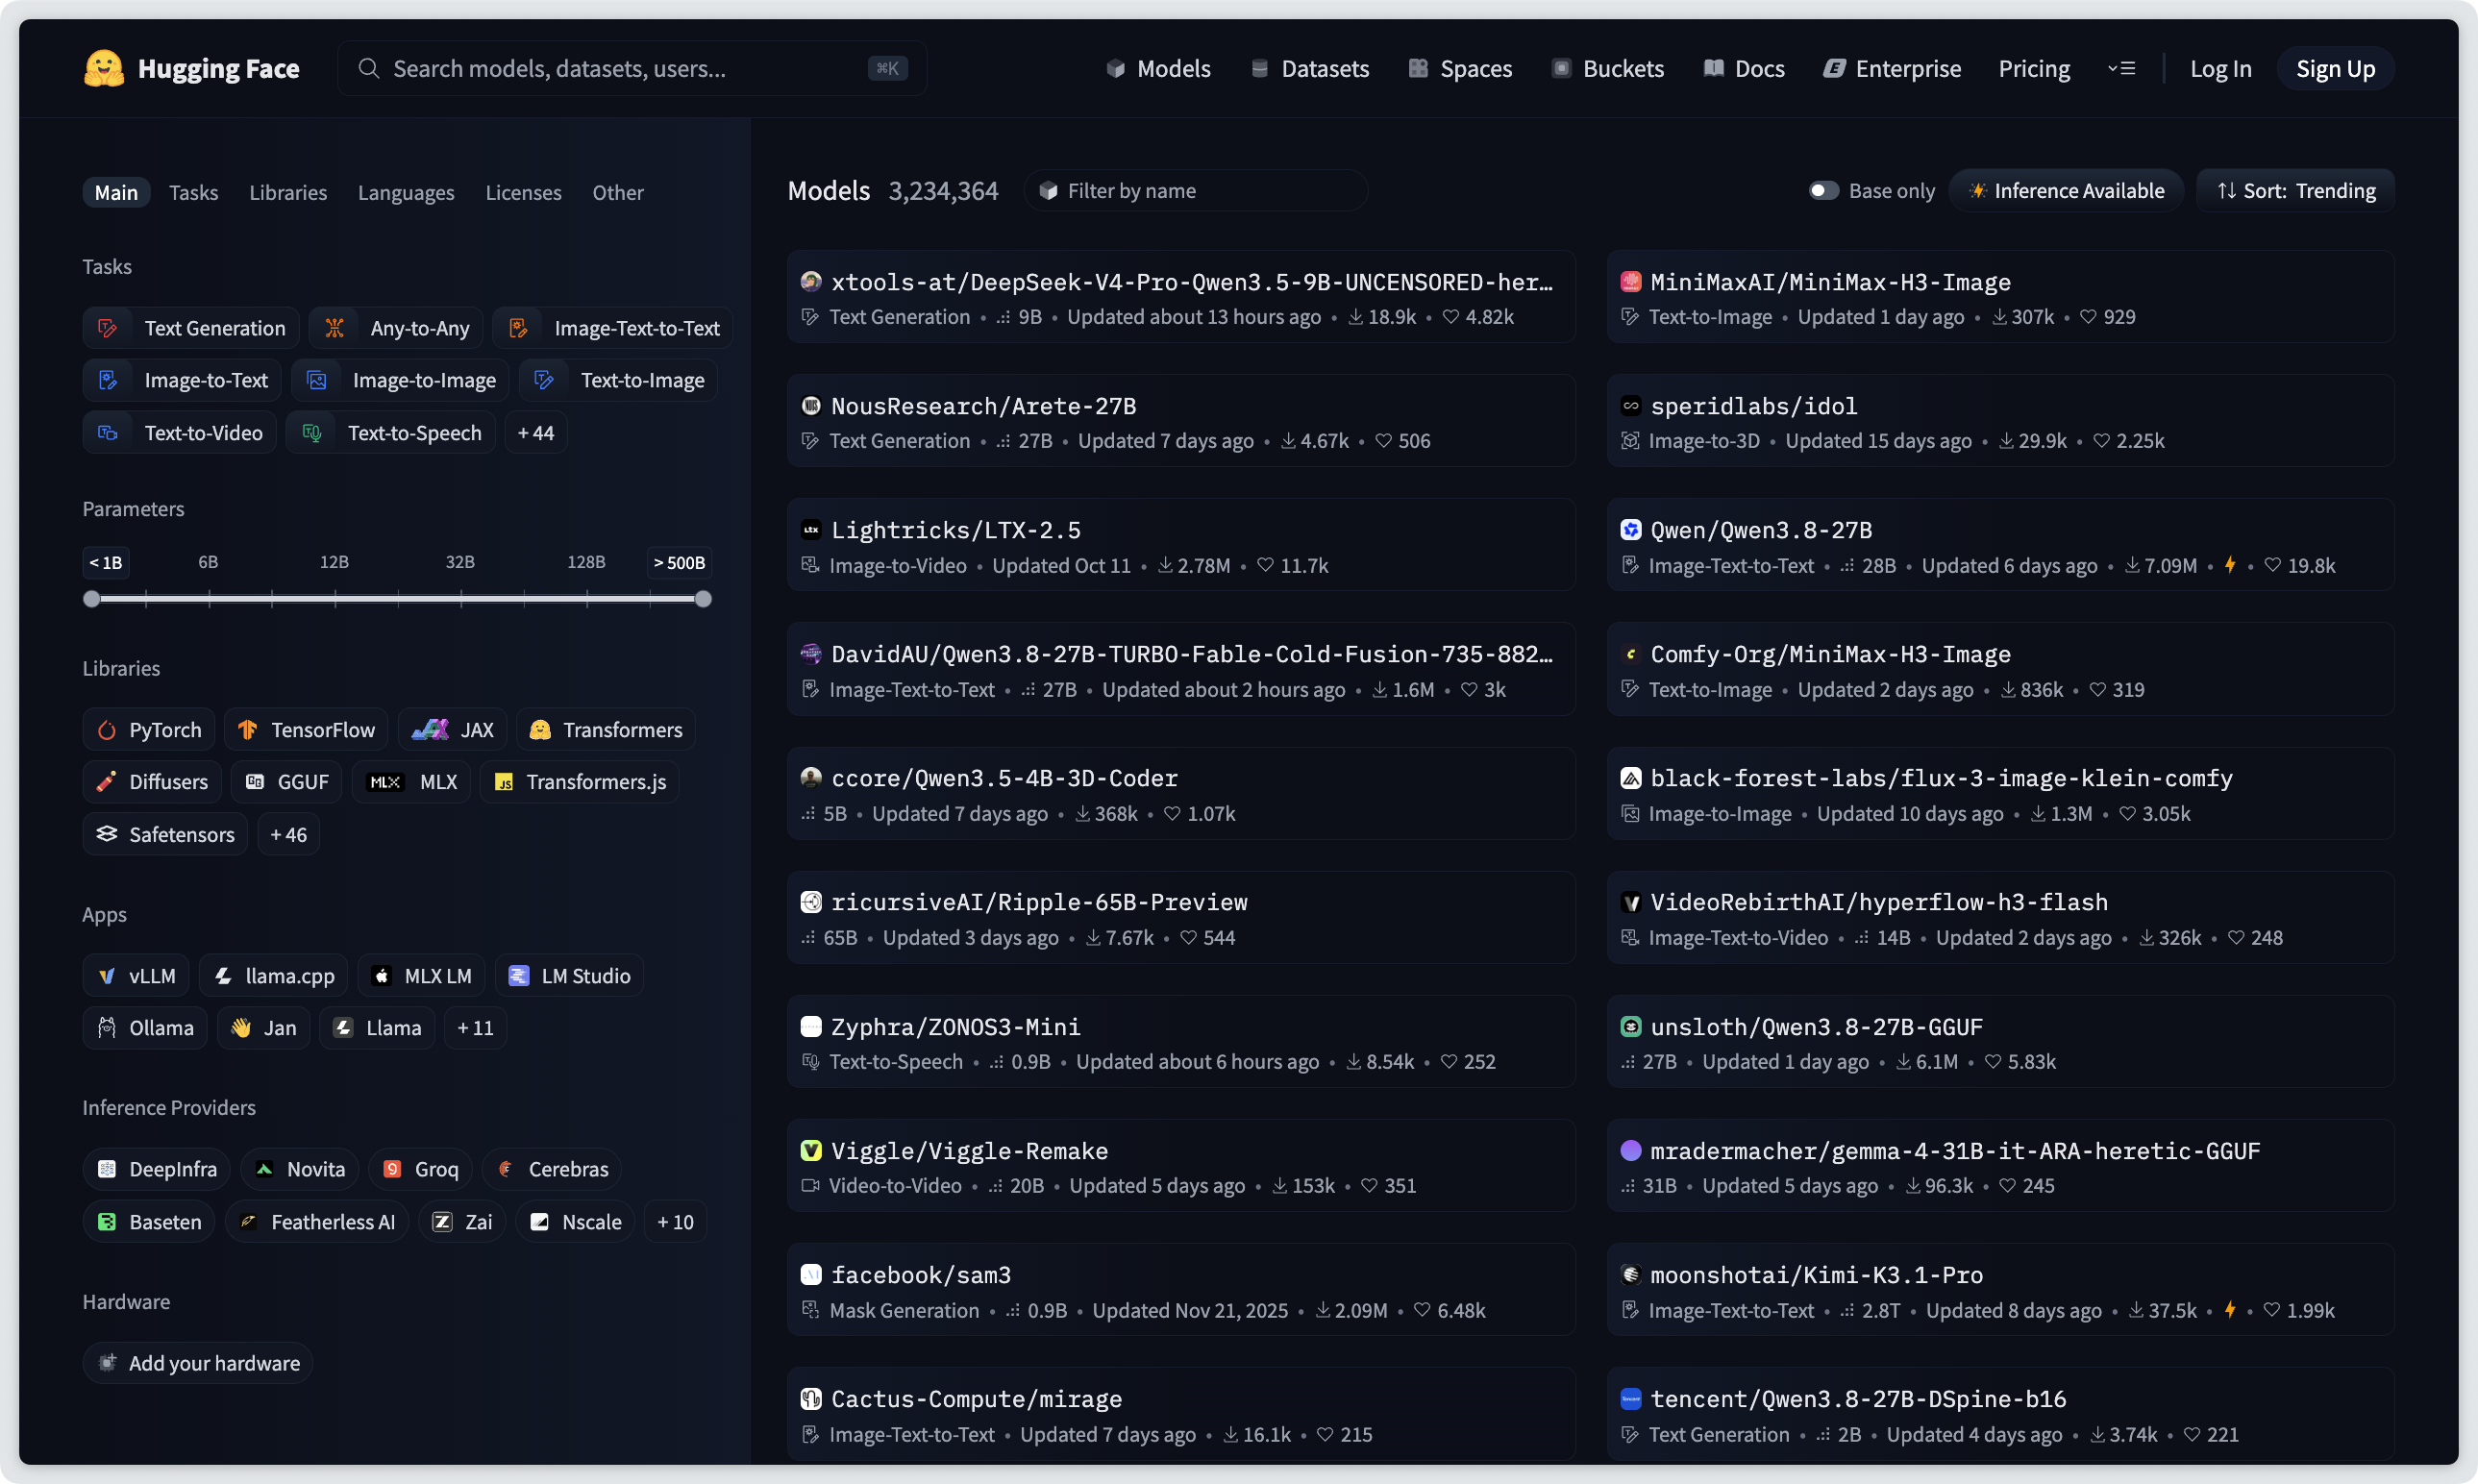
在模型平台上,常见的仓库 ID 长这样:meta-llama/Llama-3.1-8B-Instruct。斜线前通常是发布账号或组织,斜线后是仓库名。仓库里可以有配置、词表、说明文档和多个权重文件,所以仓库名不一定等于你最后下载的文件名。
例如,Meta 发布的模型仓库叫 meta-llama/Llama-3.1-8B-Instruct;社区转换出的 GGUF 文件则可能叫 Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf。前者告诉你去哪一个仓库找模型,后者还带有量化方案和文件格式信息。
例子一:Llama-3.1-8B-Instruct,适合直接聊天吗?
把 Llama-3.1-8B-Instruct 拆开看:
| 名称部分 | 大致含义 | 选模型时怎么看 |
|---|---|---|
Llama | 模型家族 | 先确认是不是你要找的系列 |
3.1 | 家族版本标记 | 版本号不等于能力说明,需看模型卡 |
8B | 约 80 亿参数 | 用于初步估算规模,不是显存需求的精确值 |
Instruct | 指令微调版本 | 通常更适合直接问答和聊天;Base 更偏预训练底座 |
如果你的目标是“下载安装到本地就开始聊天”,一般先在同一家族里找 Instruct / Chat,而不是只看参数量最大的那个。可对照 Meta Llama 3.1 8B Instruct 模型卡 和 Llama 3.1 8B Base 模型卡。
例子二:Qwen2.5-Coder-7B-Instruct-Q4_K_M.gguf,哪些部分影响本地选择?
这是一个适合讲清“用途、规模、量化、格式”的文件名:
| 名称部分 | 大致含义 | 对本地部署的提示 |
|---|---|---|
Qwen2.5 | 模型家族和版本 | 对照同系列模型卡看版本差异 |
Coder | 代码任务取向 | 写代码或解释报错时可优先评估;通用聊天不一定要选它 |
7B | 约 70 亿参数 | 比同系列大参数版本更容易作为内存初筛候选,但仍要看具体文件和设备 |
Instruct | 指令微调版本 | 通常更适合直接按要求问答和聊天 |
Q4_K_M | 量化方案标记 | 属于 llama.cpp 常见 GGUF 量化命名;不能单凭名称精确推断文件大小、效果或兼容性 |
.gguf | 文件格式 | 常见于 llama.cpp 相关本地推理工作流;它不代表量化位数 |
Qwen 官方仓库里的对应 GGUF 文件 显示文件约 4.43 GB。这个数字只是权重文件体积的参考:实际运行还要给程序、上下文缓存等留内存,所以不能据此认定“4.5 GB 内存就够”。GGUF 文档 也说明,GGUF 是一种面向推理的文件格式,仓库里可能提供多种量化文件。
例子三:Qwen3-30B-A3B,为什么 30B 模型会写 A3B?
Qwen3-30B-A3B 是 MoE(混合专家)模型。Qwen 模型卡给出的数值是总计 30.5B、每个 token 激活 3.3B。
| 名称部分 | 大致含义 | 容易误解的地方 |
|---|---|---|
30B | 约 300 亿总参数 | 全部专家权重都要存储或按运行方式加载 |
A3B | 每个 token 约激活 30 亿参数 | 激活量不等于模型文件大小,也不能按普通 3B 模型估内存 |
这两个数字回答的是不同问题:激活参数较少,通常意味着每个 token 只计算模型的一部分;但模型仍需容纳全部专家权重。所以不要看到 A3B 就把它当成普通 3B 小模型,也不要只按激活参数估算能否下载或装入内存。请看实际权重文件大小、模型架构和运行工具的硬件说明。Qwen3-30B-A3B 模型卡
量化、参数量和显存:新手最容易混淆的三件事
参数量表示模型有多少参数;量化改变权重的数值表示,通常能缩小权重文件并降低内存占用,但可能带来效果损失;运行时内存还受上下文长度、缓存、推理框架和设备影响。因此,7B 或 Q4 都不是“需要多少显存”的完整答案。
挑量化版本时,可以先看仓库是否提供多个量化文件,再在支持的格式里比较文件体积和运行效果。一般来说,压缩更强会更省空间,但效果、速度和硬件支持各有差异;不要把 Q4_K_M、Q5_K_M 当成跨所有模型都绝对可比的质量等级。下载前最好查看该模型发布者给出的推荐文件和运行说明。
本地部署选模型:按这个顺序检查
- 先定任务:普通问答、代码、图像理解、语音等,找对应模型家族或任务版本。
- 选对使用版本:直接聊天优先看
Instruct/Chat;Base通常需要进一步适配或正确的提示模板。 - 筛参数规模和实际文件大小:参数量帮助初筛,文件体积帮助估计权重空间;再为上下文和运行程序预留内存。
- 确认格式受支持:例如 GGUF 常用于 llama.cpp 相关工具;其他推理工具可能要求不同格式。以你所用工具的文档为准。
- 核对模型卡:确认来源、许可证、上下文长度、推荐配置、已知限制,以及量化文件是否由原作者或社区转换。
模型平台的任务标签、下载量、更新时间和参数展示也能辅助筛选,但它们是平台提供的信息,不是模型名称本身,也不能代替模型卡和硬件检查。
常见问题
Instruct 和 Base 怎么选?
想直接进行问答或聊天,通常先选 Instruct / Chat。需要继续训练、微调或特定生成流程时,再考虑 Base,并查看模型卡的使用说明。
Q4_K_M 是不是就是 .gguf?
不是。Q4_K_M 是量化方案标记,.gguf 是文件格式。文件名里两者可能同时出现,但表达的是不同属性。
参数量小就一定能在我的电脑上运行吗?
不一定。还要看权重精度或量化、上下文长度、推理框架、显存/内存以及模型架构。最稳妥的初筛方式是查具体文件大小和模型卡的硬件建议,并留出运行余量。
一句话总结:先按任务选模型版本,再用参数量和文件大小估算设备负担,最后确认量化与格式能被本地推理工具支持。模型名是线索,模型卡和具体权重文件才是选型依据。
延伸阅读:Meta Llama 3.1 8B Instruct · Qwen2.5-Coder 7B Instruct GGUF · Qwen3 30B A3B · Hugging Face GGUF 格式说明
